labs / 2026-09-22
スパース化で動画生成は速くなるか — 3条件の実測
動画生成の計算を削ると、どれだけ速くなって、絵は何が変わるのか。何もしていない状態から積み上げ直して、どの手が何秒ぶん稼いでいるのかを測りました。同じ先頭の1枚から3条件を走らせた比較動画も並べてあります。測り方の落とし穴と、途中で自分の出した結論を取り下げたところまで載せています。
分かったこと
何もしていない状態から 5.7倍。うちスパース化の取り分は約2倍
素のH3(20ステップ)312.8秒 が、ターボLoRA+スパース化で 55.0秒。サンプリングだけで見れば 9.19倍。ただし足し算にはならない — スパース化は20ステップの上では3.13倍効くのに、4ステップの上に足すと1.96倍にしかならない。先に削るほど、次の取り分が減る。
削れば速くはなる。だが下げ続けても止まる
アテンションを100%→10%にすると2.8倍速くなる。そこから5%まで半分にしても、サンプリング時間は3〜5%しか縮まない。解像度もフレーム数も違う3条件で同じ幅に収まった。
AIに配分を決めさせても、AIは判断していない
層の役割を説明する文章を、意味だけ逆さにして同じことを聞くと、配分もきれいに反転した。同じ質問を繰り返したときのブレは0.11ポイント、反転による差は6.49ポイント。答えを決めているのは、質問を書いた人間のほう。
画質は崩れない
原寸で切り出して見ても、ネオンの縁も水しぶきの粒も保たれている。6シーンを3条件ずつ並べたので、そのまま見比べられる。
3条件の比較
同じ先頭フレーム・同じ乱数・同じプロンプトから、3条件を走らせたものです。左から「何も削らない」「AIが層ごとに配分」「同じ平均で一律に削る」。右2つは平均の計算量をそろえてあるので、違いは配分のしかただけです。
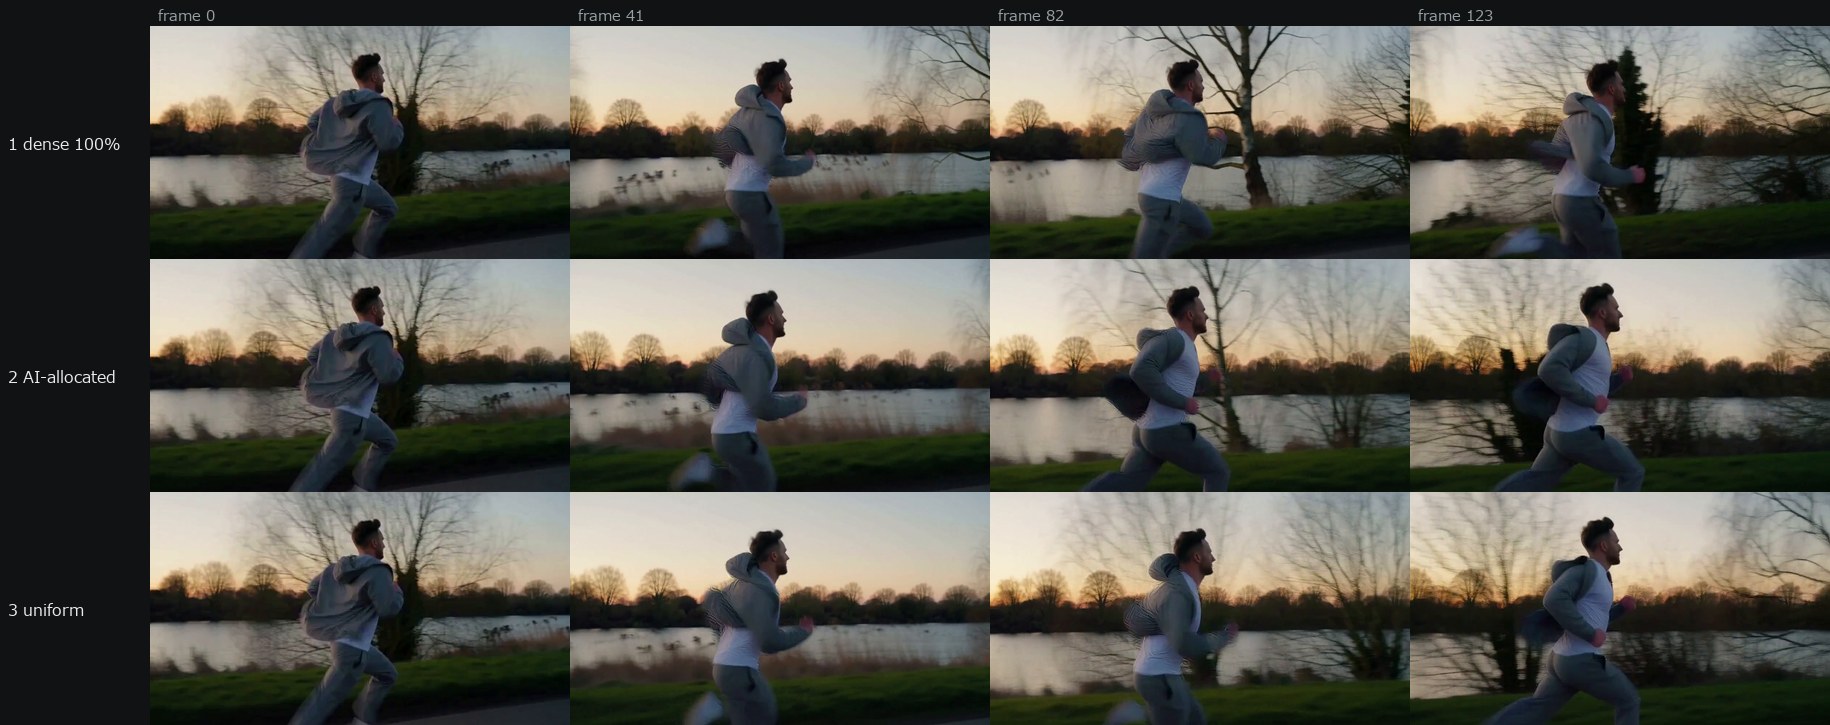
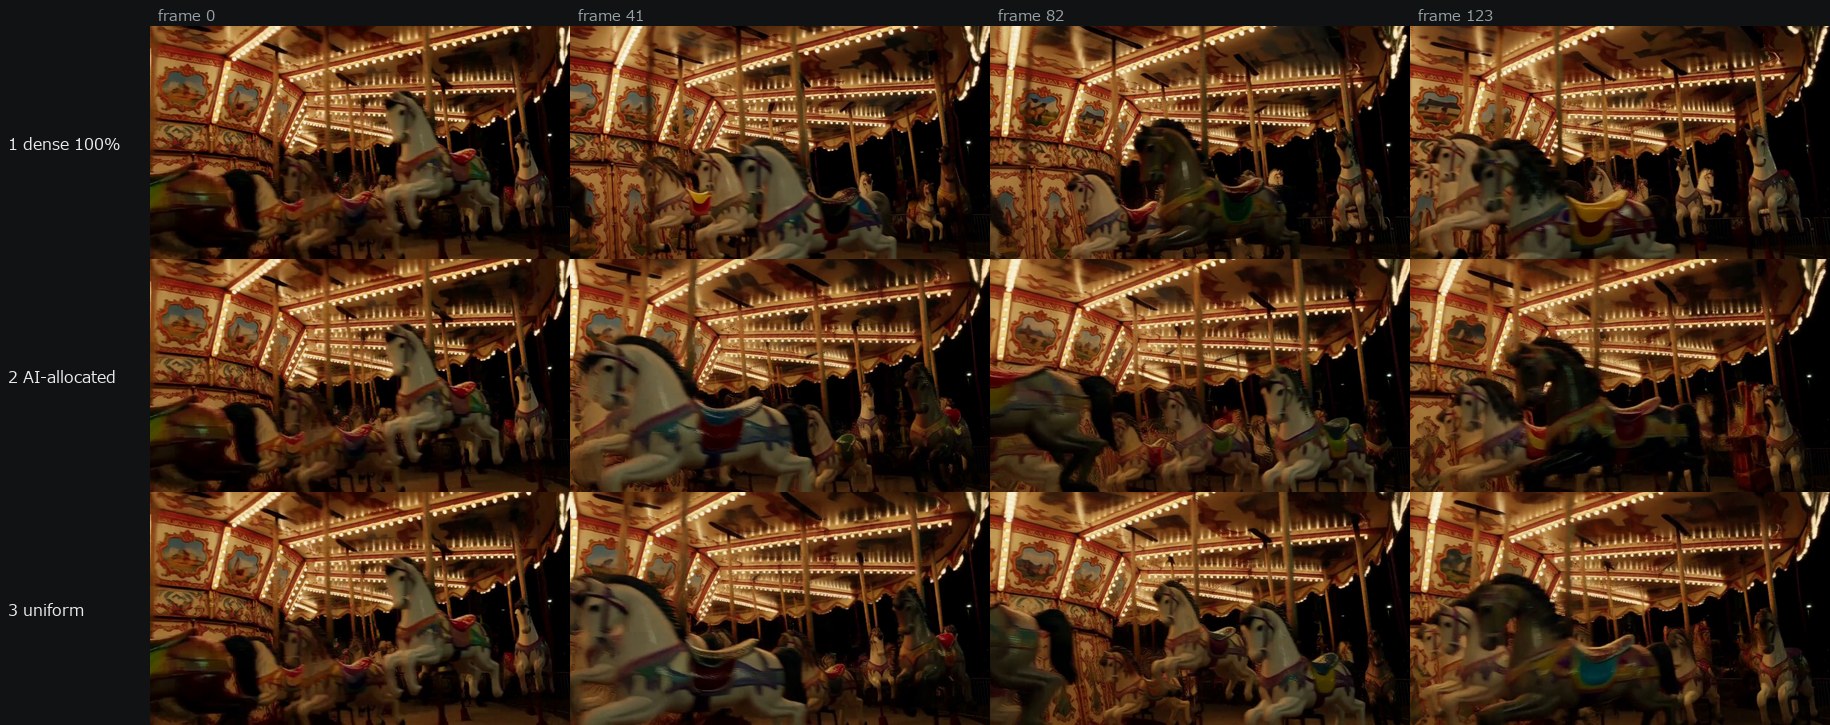
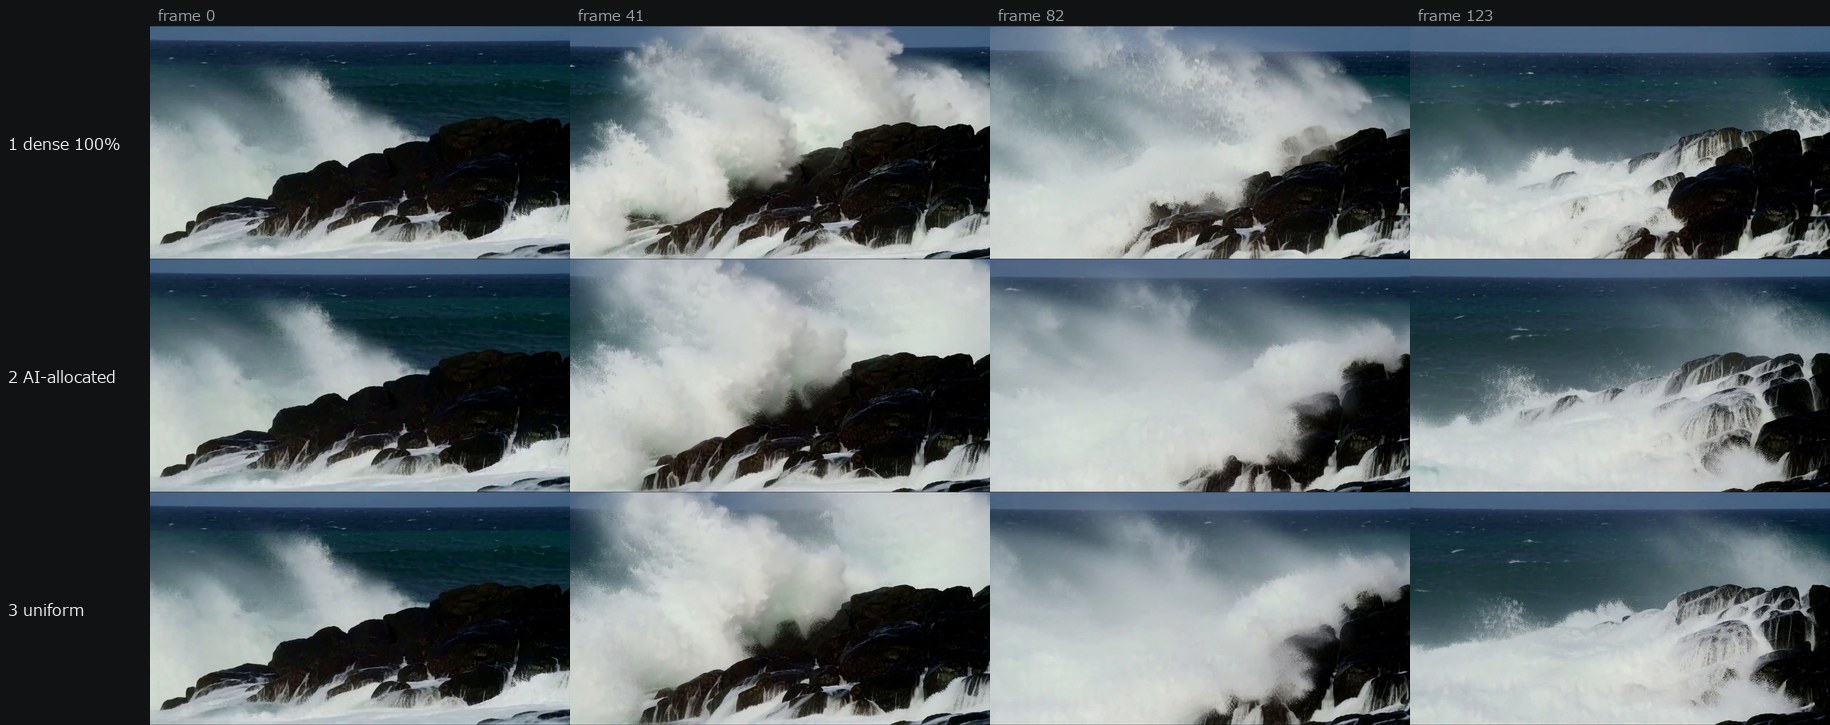
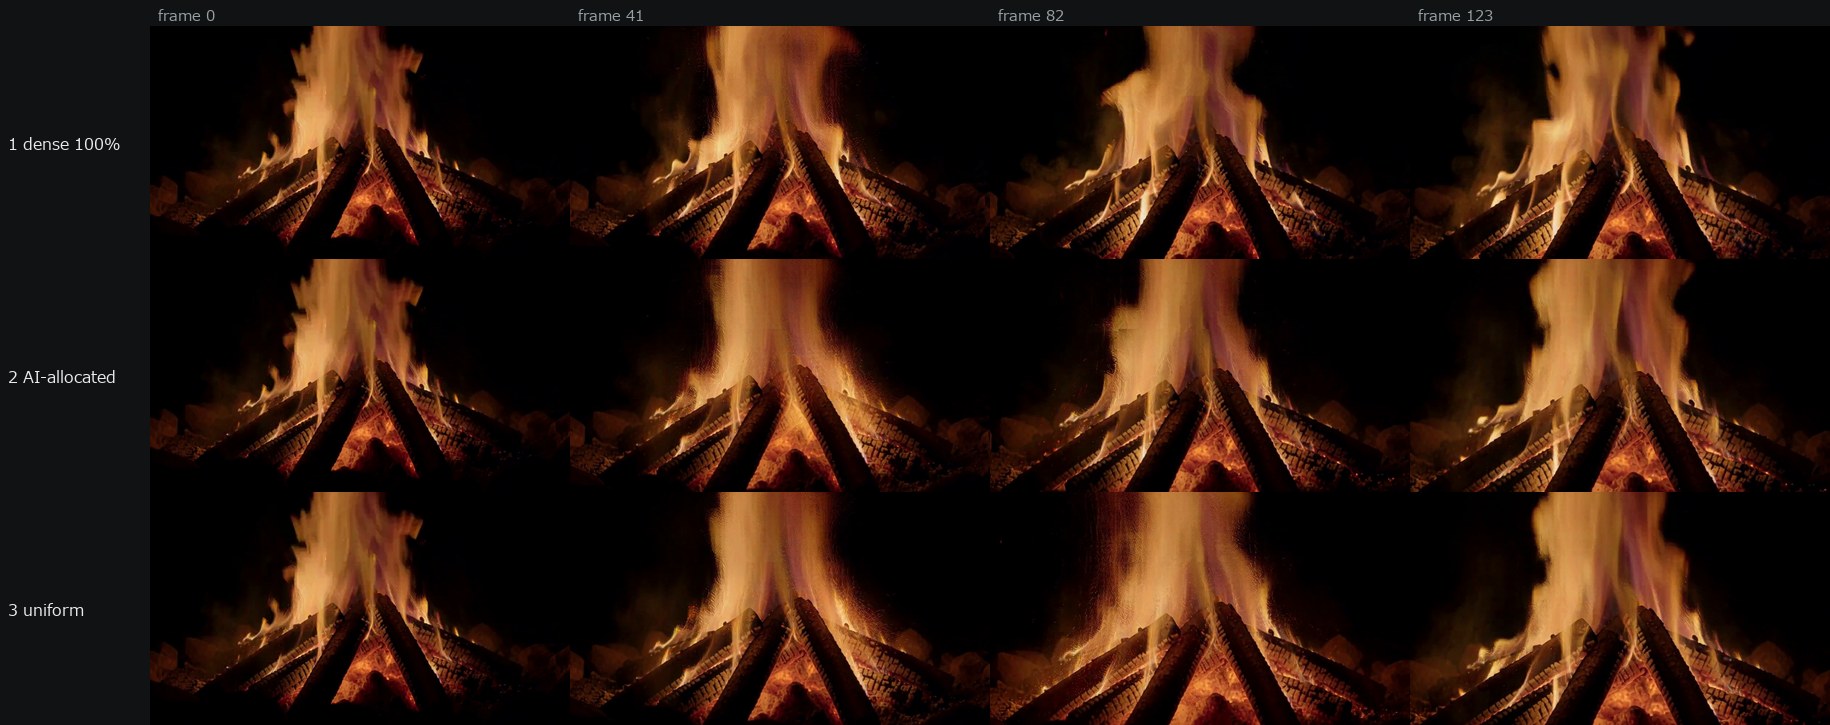
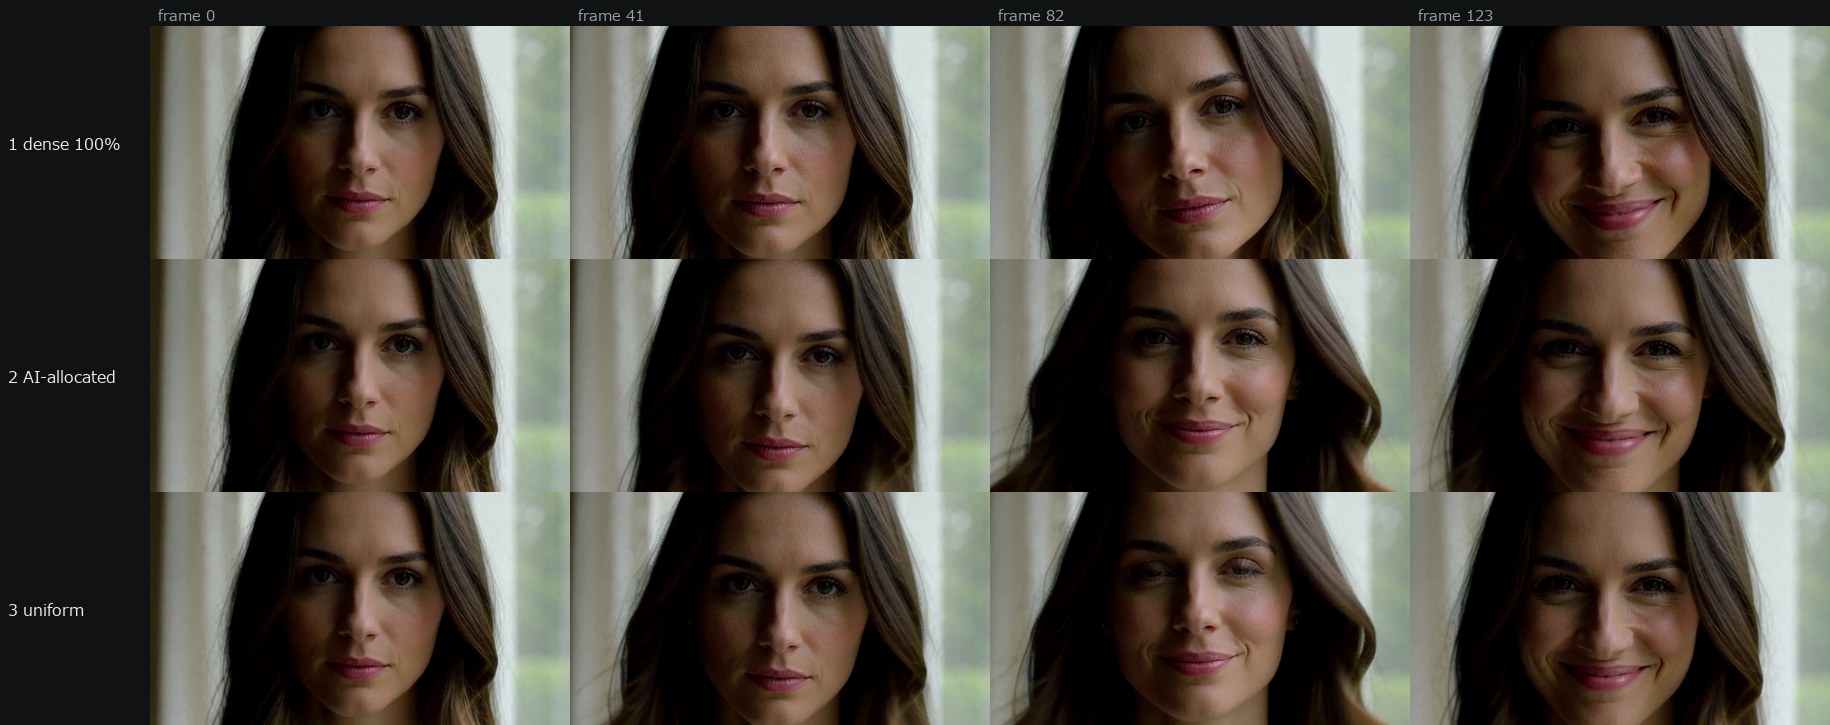
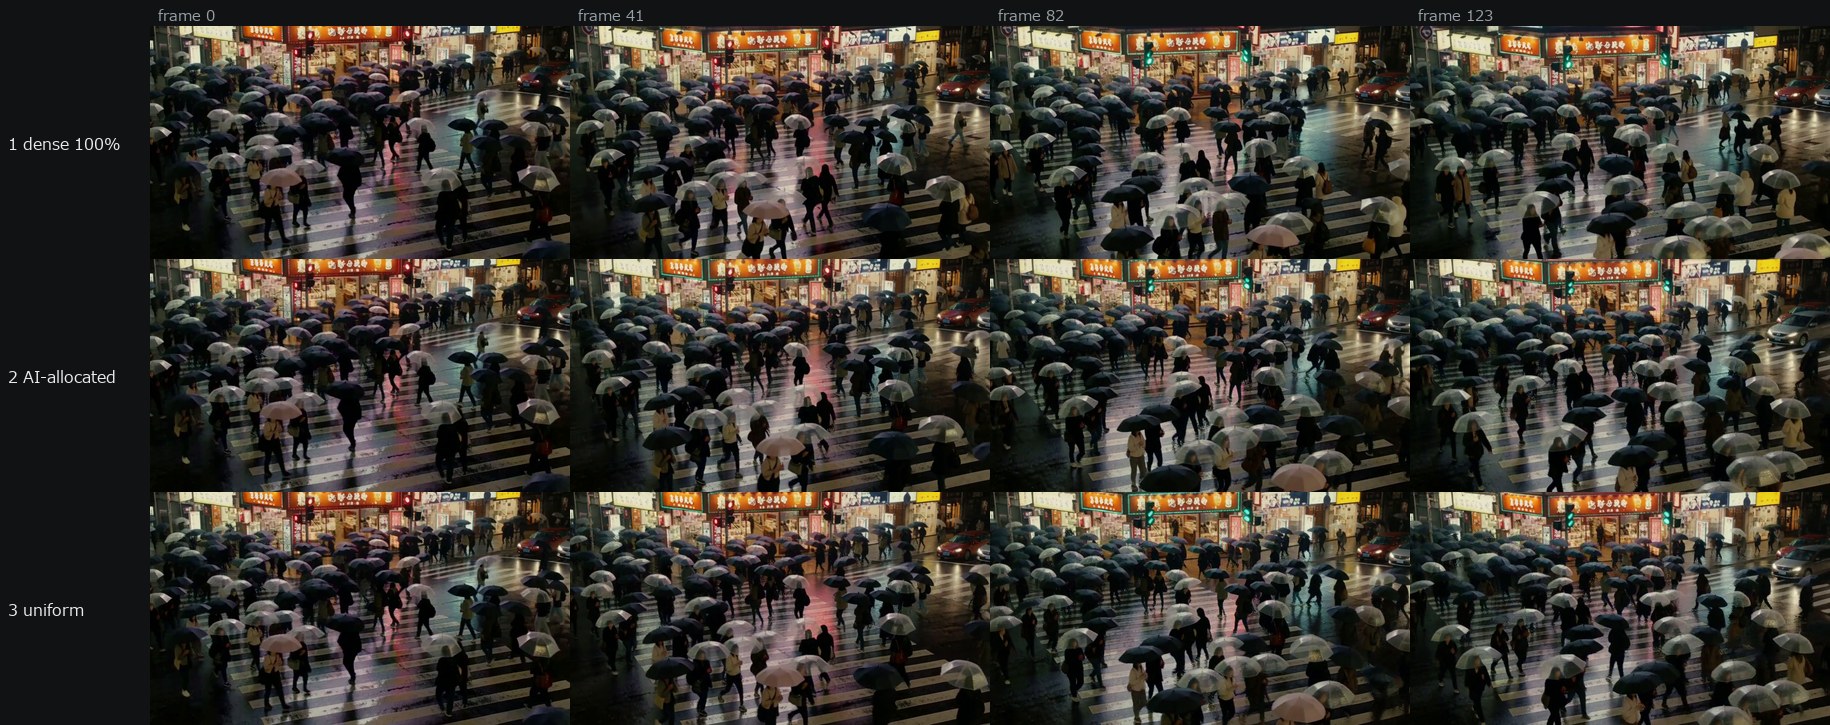
音声も生成されていますが、3本同時再生のため既定では消音です。1本だけ音を出すには、その動画の音量ボタンを押してください。1本ごとの生成秒数は、あえて載せていません。同じ条件でも1回の計測では2倍近くぶれることが分かっているので(下の計測の章)、動画の横に置くと読み違えのもとになるためです。
何が、どれだけ速くしているのか
ここまでの比較は、どれもターボLoRAを入れた状態を「素のまま」と呼んでいました。つまりスパース化の2倍は、すでに速くなった状態からさらに2倍という意味です。何も入れていないところから積み上げ直して、どれがどれだけ稼いでいるのかを測りました。同じ題材・同じ乱数・1152×640・124フレーム。モデルの読み込み時間を計測から外すため、サンプリングの秒数も併記します。
| 条件 | サンプリング | 全体 | 何もしていない比 |
|---|---|---|---|
| 何もしていない(LoRAなし・20ステップ) | 290.5s | 312.8s | 1.00倍 |
| + スパース化だけ | 92.9s | 116.8s | 3.13倍 |
| + ターボLoRAだけ(4ステップ) | 62.0s | 85.0s | 4.68倍 |
| + 両方(いまの本番設定) | 31.6s | 55.0s | 9.19倍 |
| (参考)LoRAなしで4ステップにしただけ | 58.4s | 91.2s | 4.98倍 |
① ターボLoRAは、1ステップを速くしているわけではない
同じ4ステップどうしで比べると、LoRAあり 62.0秒 / LoRAなし 58.4秒。むしろLoRAを入れたほうが6%重い。ターボLoRAの効果は「1ステップを速くすること」ではなく、20ステップ必要だったものを4ステップで済ませられることそのものでした。
② 掛け合わせは足し算にならない。後から足すほど取り分が減る
スパース化は、20ステップの上では 3.13倍 効きます。ところが4ステップの上に足すと 1.96倍 にしかなりません。アテンション以外の固定費が、ステップ数を削るほど相対的に大きくなるためです。先に片方で削っておくほど、もう片方の取り分は小さくなります。
③ 実際に待つ時間は 5.7倍
サンプリングでは9.19倍ですが、実際に待つ全体の時間は 312.8秒 → 55.0秒 で 5.7倍。差はサンプリング以外(VAEのデコード・動画の書き出し・保存)で、どの条件でも22〜33秒かかっています。ここは削れません。
他に試して、使わなかったもの
速くする方法はこれだけではありません。試したもののうち、使わなかったものと理由です。
| 手法 | 追加で入れるもの | 効果 | 採否 |
|---|---|---|---|
| ターボLoRA 4step | 1.82 GB | 4.68倍 | 採用 |
| スパース化(SLA) | 0 GB | 1.96〜3.13倍 | 採用 |
| FastH3 8step V2 | 20.61 GB | 当初1.41倍 → いまは負け | 不採用 |
| Spectrum | カスタムノード | −28.2%(本物) | 不採用・再現性が壊れる |
| EasyCache / LazyCache | カスタムノード | 20stepなら1.50倍。4stepでは0 | 不採用 |
| torch.compile / SageAttention | — | 測れていない | 見送り |
計測 — どこで時間を使っているか
最初に出した結論は、間違った物差しで測っていました。生成全体の秒数には、条件と関係なくブレる部分(モデルの読み込みなど)が最大11秒混ざっていて、比べようとしていた差と同じ大きさでした。サンプリングだけを取り出すと、話がはっきりします。
keep率を半分にしたときの変化
サンプリングは3条件とも −3〜5%。全体の秒数は +4.6% 〜 −18.3% でばらつくだけ。
| 条件 | サンプリング | 全体 |
|---|---|---|
| 1024x1792 124f | -3.0% | +4.6% |
| 1152x640 124f | -3.7% | -18.3% |
| 1152x640 192f | -4.9% | -2.2% |
すべての計測
| 条件 | 平均keep | サンプリング | 全体 | それ以外 |
|---|---|---|---|---|
| A — DENSE (100%) | 100.00% | 284.72s | 339.0s | 54.28s |
| B — 固定 10% | 10.00% | 75.16s | 120.7s | 45.54s |
| C — 固定 7.93%(元事例のJev平均) | 7.93% | 79.84s | 133.8s | 53.96s |
| D — Jev-guided | 6.64% | 72.48s | 123.9s | 51.42s |
| P0 — 層別テスト(1/3/5/10を循環) | 4.75% | 72.91s | 126.2s | 53.29s |
| N_124f_dense | dense | — | 103.8s | — |
| N_124f_keep10 | 10.00% | 31.11s | 68.9s | 37.79s |
| N_124f_keep5 | 5.00% | 29.95s | 56.3s | 26.35s |
| N_192f_dense | dense | — | 158.7s | — |
| N_192f_keep10 | 10.00% | 47.07s | 82.8s | 35.73s |
| N_192f_keep5 | 5.00% | 44.75s | 81.0s | 36.25s |
配分を変えても速くならない
平均の計算量をそろえ、配分のしかただけを変えて交互に測りました。ときどき2倍近い外れ値が出ますが、それは両方の条件に同じように出ます。適用された keep 率は速い回も遅い回も1バイト違わないので、中身ではなく実行環境の揺れです。中央値で見ると AI配分 40.22秒 / 一律 37.56秒。配分を変えても生成時間は動きません。
| 回 | AIが配分 | 一律(同じ平均) |
|---|---|---|
| 1 | 35.78s | 35.00s |
| 2 | 40.22s | 86.86s |
| 3 | 70.07s | 37.56s |
| 中央値 | 40.22s | 37.56s |
削ると、明るいほうへ寄りやすい
3条件とも同じ先頭フレームから始めているので、そこからどれだけ離れたかは横に並べて比べられます。コマ0とコマ123で、明るさ・コントラスト・彩度を測りました。数字は変化量です。
| シーン | 条件 | 明るさ | コントラスト | 彩度 |
|---|---|---|---|---|
| 走る人(脚の回転) | ① 何も削らない | -0.2 | -0.8 | -2.5 |
| ② AIが配分 | +7.5 | +5.5 | +0.0 | |
| ③ 一律に削る | +2.8 | +1.7 | +3.6 | |
| メリーゴーランド(回転の連続性) | ① 何も削らない | +1.9 | +0.5 | -16.5 |
| ② AIが配分 | -3.2 | +1.2 | -4.9 | |
| ③ 一律に削る | -1.7 | +0.2 | -8.5 | |
| 砕ける波(高周波の水しぶき) | ① 何も削らない | +9.9 | -2.6 | -10.9 |
| ② AIが配分 | +25.2 | -5.2 | -27.0 | |
| ③ 一律に削る | +29.9 | -3.7 | -29.5 | |
| 焚き火(不規則なゆらぎ) | ① 何も削らない | +11.2 | +7.1 | +20.8 |
| ② AIが配分 | +14.9 | +8.4 | +31.8 | |
| ③ 一律に削る | +14.6 | +9.2 | +30.5 | |
| 顔の寄り(同一性とまばたき) | ① 何も削らない | -2.8 | -1.1 | -0.7 |
| ② AIが配分 | -9.5 | -1.4 | +4.9 | |
| ③ 一律に削る | -3.4 | +1.7 | +2.7 | |
| 交差点の群衆(多数の小物体) | ① 何も削らない | +10.4 | +2.0 | -8.8 |
| ② AIが配分 | +7.7 | +3.8 | -4.1 | |
| ③ 一律に削る | +4.8 | +2.7 | -5.7 | |
| 6シーン平均 | ① 何も削らない | +5.09 | +0.86 | -3.09 |
| ② AIが配分 | +7.09 | +2.04 | +0.13 | |
| ③ 一律に削る | +7.85 | +1.96 | -1.16 |
1シーンにつき1本ずつなので、傾向以上のことは言えません。
AIは、判断しているように見えて、判断していない
結論から書きます。AIに「どこにどれだけ計算を割くか」を決めさせると、いかにも考えたような答えが返ってきます。でもそれは、こちらが質問文に書いた説明を、そのままなぞっているだけでした。AIは、割り振る相手の中身を見ていません。
どうやって確かめたか
動画を作るモデルの中には、処理の層が50段あります。その1層ずつについて「ここにどれだけ計算を割くべきか」をAIに聞きました。聞くときに、こちらから「この層は入口に近い」「この層は出口に近い」という説明を添えています。
返ってきたのは「入口に近いほど少なく、出口に近いほど多く」という配分でした。もっともらしく見えます。
そこでその説明だけを入れ替えて、もう一度まったく同じことを聞きました。選択肢も、層の番号も、他の文章も一字も変えていません。入口の層に「出口に近い」と書き、出口の層に「入口に近い」と書いただけです。
| 層の位置 | 元の説明 | 説明を入れ替え | 差 |
|---|---|---|---|
| 層0–9 | 3.13% | 9.62% | +6.49 |
| 層10–19 | 3.52% | 8.38% | +4.86 |
| 層20–29 | 6.97% | 6.66% | -0.31 |
| 層30–39 | 9.38% | 4.42% | -4.96 |
| 層40–49 | 10.00% | 4.00% | -6.00 |
AIが自信を持って答えたぶんだけを取り出すと、3 / 3 / 8.3 / 10 / 10 と 10 / 10 / 8.3 / 3 / 3。ぴたりと裏返しです。
つまり答えを決めていたのは、AIではなく質問を書いた人間のほうでした。AIはこの50層が実際に何をしているかを知りません。渡せるのは「何番目か」と、こちらが書いた説明だけです。
ただし、まったく気づいていないわけでもありません。説明と番号が食い違う文章を渡すと、AIの自信は明らかに下がりました(自信が足りずに既定値へ逃げた割合が17%から43%へ)。それでも答えは、こちらの書いた説明のほうに従います。
測り方
MiniMax H3(1024×1792 と 1152×640、124/192フレーム、4ステップ、er_sde、 4ステップ用のターボLoRA)を RTX 5080 16GB で回しています。 アテンションの削り方は ComfyUI 本体に入っている SLA(各クエリブロックが保持するキーブロックの割合)で、 本体のコードは書き換えていません。 「ステップ×層ごとに割合を差し替える」ためだけの小さな追加ノードを1つ足しています。
3条件の比較動画は、先頭の1枚を同じファイルで渡しています。 スパース化は計算そのものを変えるため、同じ乱数でも同じ絵にはなりません。 そのまま並べると「違う動画が3本ある」だけになるので、出発点をそろえました。
なお、生成AIは設定とシード値がすべて同じなら、何度回しても同じものを出します (同じ設定で回し直して画素差 0.00 を確認しました)。逆に、スパース化でもステップ数でも、 設定を1つ変えれば出てくるものは変わります。3条件の動画が別々の絵になっているのはそのためです。
動画は再エンコードしていません。
画質を見比べるページで再圧縮すると、見ているものがスパース化の差なのか
圧縮の差なのか分からなくなるためです。ブラウザで先に再生が始まるよう、
コンテナの並べ替え(-c copy)だけ行っています。
元データ
このページの数字は、すべて生成時に自動で書き出した記録から取っています。手で打ち直した数字はありません。
- 生成ごとに、実際に使われた keep 率(4ステップ×50層=200箇所)とサンプリング秒数を JSON に自動保存
- 生成時間は ComfyUI 側の実行開始/終了のタイムスタンプ
- AIへの質問と回答(確信度つき)も 6回ぶんすべて保存
- グラフはその JSON から組み立てています